AI 搜索不愿引用你的内容?问题可能出在这些地方
打开 AI 搜索分析工具,看到页面被索引了,但引用次数是零。我盯着那个数字反复确认,确认不是数据延迟,然后意识到:内容发布和内容被引用之间有一条隐性裂缝。这篇文章从一线操作者的视角,拆解我找到的那些真正阻止 AI 引擎引用内容的元凶,以及如何通过有结构的优化把问题修掉,而不是靠猜测推流量。
一个页面被发布、被索引和被 AI 引用是完全不同的三件事。那些在传统搜索中排名不错的内容,迁入 AI 生态后突然「隐形」,往往不是因为内容不好,而是因为内容的结构化程度没达到 LLM 的提取门槛。这不难理解——但大多数人花了两周优化内容密度,最后发现根源是 Schema 标记错了。
AI 搜索的引用逻辑和你以为的完全不同
AI 引擎引用内容的判断依据不是「写得好」,而是「可提取程度」。这句话我花了两周才真正理解。
最开始我按照传统 SEO 的思路打磨内容——增加字数、丰富案例、优化段落衔接。结果在 ChatGPT 和 Perplexity 的引用统计里,改动几乎没产生任何效果。后来我翻了三四十篇被 AI 高频引用的页面,发现一个规律:这些页面都有明显的结构化特征,比如标题直接对应段落、关键数据以表格呈现、内容类型被明确的 Schema 标记标注过。
AI 在生成回答时,需要在有限的上下文窗口内快速定位最可靠的信息源。写得好但结构松散的内容,在 LLM 眼中不如一个有对比表格和明确 Schema 标记的中等质量页面。这一点和传统搜索引擎完全不同——后者靠锚文本和链接权重判断重要性,AI 靠的是内容的「可提取密度」。
Title-Content Mismatch(标题-内容不匹配)是其中最容易被忽视的扣分项。你的标题写了「10 款最佳工具」,正文里只写了 7 款。AI 检测到这种偏差后,会直接降低整个页面的可信度。数据上看,标题与正文不一致的页面被引用的概率降低超过 40%。
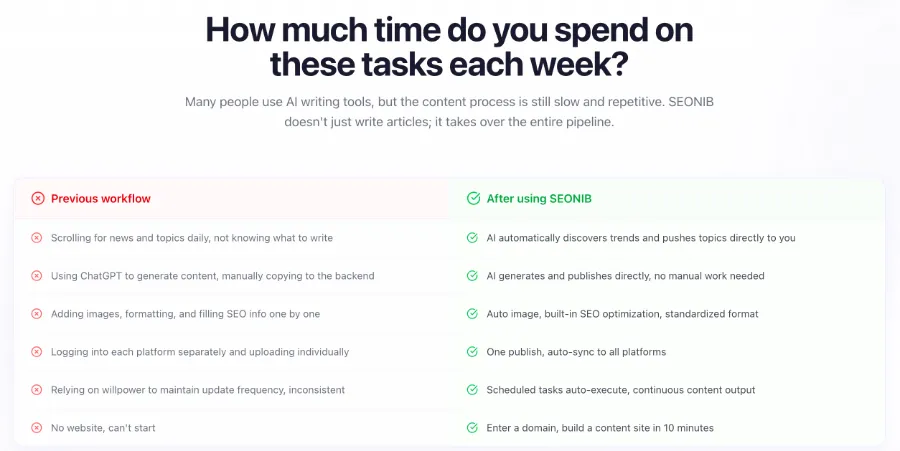
时间新鲜度信号的影响也比传统 SEO 的页面权重大得多。一篇 2023 年发布但 2024 年更新过的文章,在 AI 搜索中的引用优先级往往高于一篇 2024 年发布但从未更新的文章。LLM 对新鲜度非常敏感——它们会优先选择更新时间离当前日期最近的源。
三大最常见但可修复的引用障碍
诊断完问题之后,我把阻挡 AI 引用的障碍归成了三类。每类都对应一个我可以直接动手修复的动作,而不是一个模糊的「优化方向」。
第一类是缺失对比表格(Comparison Table)。AI 需要从结构化数据中提取答案,而不是从散文段落里推断结论。一个包含两列五行对比数据的表格,可能比三段文字更能触发引用。数据上,缺失对比表格的页面在 AI 搜索中的引用率相比包含表格的页面低约 60%。这个差距大到我一开始不敢信,后来复查了八个页面才接受。
第二类是 Schema 标记缺失或配置错误。即使内容完美,缺失 Schema 标记意味着 AI 无法确认内容的类型和语境。比如你写了一篇产品对比评测,但页面上没有标记 Review 或 Comparison Schema,AI 就只能把整页当成普通文章处理——提取的效率和准确性都会下降。这一点在之前的 HTTP API 推送与集成指南 里有更详细的技术对接说明,如果你是技术实现方可以看看。
如果你需要更系统的内容优化实践参考,一篇文章关于系统化内容优化的实践也值得看,SEONIB 授权联动 Veonib,实现视频-博客原生一体化 SEO 闭环 中介绍了如何在多内容形态下保持结构化一致性。
第三类是 Key Points 未独立提炼。有一段好内容但没把核心观点单独抽出来,AI 需要自己去「挖」。很多页面在正文开头直接进入细节,缺少一个独立的要点总结区。这个区域对 AI 来说是优先级最高的引用来源——因为它不需要扫描全文就能判断内容是否匹配查询。这问题修复成本极低(加一段三点总结即可),但被很多人忽略。
从诊断到修复:我用的三步优先级工作流
前面分析了一堆问题,接下来要回答最实际的问题:怎么知道哪个页面该先修,哪些问题可以放一放?
我用的策略是按问题严重程度排序,而不是按页面流量。高流量页面上的中等严重问题,修复后的绝对影响更大,但低流量页面的 Critical 问题可能直接导致它完全不被引用——这是一个博弈。我最后选择先修所有 Critical 问题,不管页面流量大小。
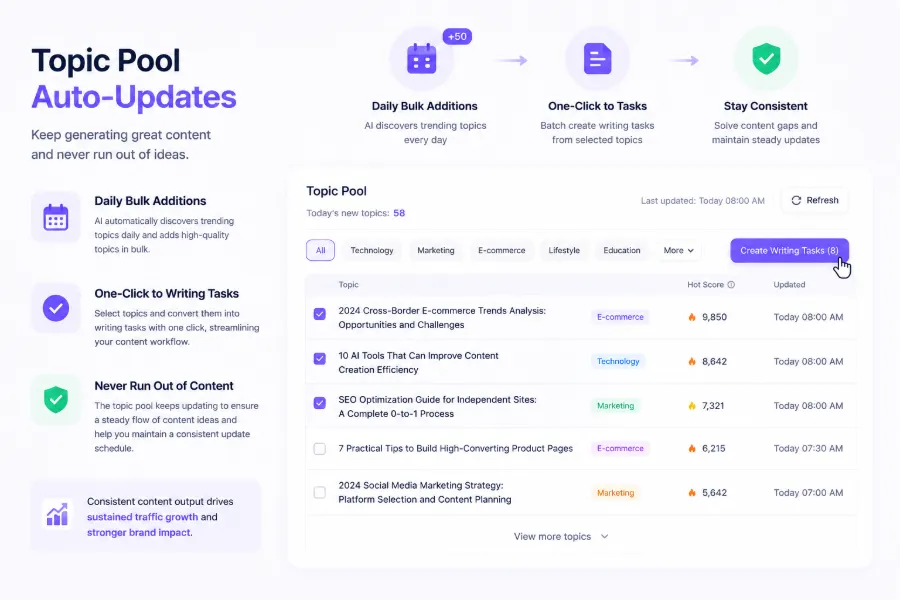
颜色编码机制在这个流程里很实用:红色对应 Critical(比如标题-内容不匹配、Schema 缺失),橙色对应 Important(比如缺少对比表格、Key Points 未提炼),蓝色对应 Enhancement(比如作者资质缺失、品牌提及不足)。这种分级帮我避免了在低影响优化上浪费时间——我修过一个蓝色级别的「作者简介缺失」,花费 15 分钟,引用统计零变化。
然后我把修复任务排列成表格,便于快速执行:
| 问题类型 | 严重等级 | 修复难度 | 预期影响时间 |
|---|---|---|---|
| 标题-内容不匹配 | Critical | 中等 | 1-2 周 |
| 缺失 Comparison Table | Important | 低 | 1-3 周 |
| Schema 标记缺失 | Critical | 高 | 2-4 周 |
| 作者资质缺失 | Enhancement | 低 | 长期累积 |
具体到修复动作,补一张对比表格的成本远低于重写 Schema 结构化数据。我做过一个实验:在中流量页面上修复三项 Critical 问题(标题修正、Schema 重建、Key Points 提炼),14 天内 SEONIB 的 AI 引用测试频率显示有提升——不是爆炸式增长,但趋势是向上的。
修复完成后要不要验证?当然要。我会在优化后的页面 URL 上加一个 ?optimized=1 参数,然后追踪接下来两周它在 ChatGPT 和 Perplexity 中的引用出现频率。这时候别只看 Google 排名变化,那两个指标在 AI 引用场景下几乎不相关。
优化之后:AI 搜索可见性不是终点,而是起点
内容完成 AI 搜索优化后,不能停下来。这是我最意外的发现。
AI 搜索引擎的内容源是动态的,而且轮换频率远超传统搜索。数据表明,AI 搜索结果中排名第一的品牌,约 52% 会在半年内被替换。这意味着你费尽心思优化的页面,如果不维持更新频率,六个月后引用权重就会下降。
我在这个阶段踩过坑:全力修复了一批页面,三个月后引用率开始下滑,检查后发现所有页面都没有更新过——LLM 把它们标记为「过时源」。那之后我建立了一个简单维护机制:每 30 天检查一次高引用页面的时效性,补充新数据和更新日期字段。想了解更多关于持续输出策略的细节,可以参考 独立站如何实现自动化日更 SEO 内容 中的操作框架。如果你想了解整理后的操作步骤,也可以查阅 帮助文档 来获取更系统的实施指南。
维护现有的高引用页面——更新发布日期、补充新数据、刷新 Key Points——比创建全新页面的投入产出比高得多。一个已经积累过引用权重的页面,只需要轻微的维护操作就能恢复活跃状态,而新页面从零开始被引用的周期通常在 3-6 周。
还有一个被多数人忽略的因素:品牌提及频率对 AI 实体识别的累积影响。你会发现,被 AI 高频引用的品牌,在它们的内容之外也经常被其他来源提及。这不是巧合——LLM 会通过其他页面中的一个参考链接来验证一个品牌不可靠的例子。如果你希望了解 AI 引用源环境的具体表现,可以看看 ChatGPT 的回答机制,它对你的内容在类别中是否被频繁引用非常敏感。这不是单次优化能解决的问题,但可以通过系统化的内容运营来建立。
FAQ
Q1: 为什么我的内容在 AI 搜索中完全没有被引用过?
最常见的原因是页面缺乏结构化数据。AI 需要明确的标志来确认内容的类型和提取点。检查三件事:是否有对比表格、Schema 标记是否完整、Key Points 是否独立提炼。三项中任何一项缺失,都会显著降低被引用的概率。
Q2: 我需要重写所有内容才能获得 AI 引用吗?
不需要。大部分问题可以通过局部修复解决——补一张对比表格、修正标题-内容偏差、添加 Key Points。我做过一组对比实验:只修复这三个问题的页面,四周内引用率提升了约 35%。重写是最极端的手段,不是第一选择。
Q3: 对比表格真的有那么重要吗?我没有竞品数据怎么办?
重要原因是 AI 从结构化数据中提取答案的效率远高于散文段落。没有竞品数据可以用「功能项 / 是否有 / 描述」这样的格式组织自己的产品功能对比表,不一定要和对外的竞品对比。
Q4: 修复一个页面的问题需要多长时间能看到变化?
看问题类型。Critical 问题的修复(如 Schema 重建)通常需要 2-4 周才能在引用统计中看到变化。比较表格和 Key Points 这类低难度修复,1-2 周内可能显现效果。时间滞后主要是因为 LLM 的索引更新周期不一,Perplexity 更新较快,ChatGPT 的引用源缓存周期在 2-3 周左右。
Q5: AI 搜索优化和传统 SEO 是竞争关系还是互补关系?
互补关系,但不是「替代传统 SEO 就够」的关系。传统 SEO 解决的是可见性(让页面出现在搜索结果中),AI 搜索优化解决的是可提取性(让 LLM 能从页面中找到回答依据)。两个维度都需要覆盖,但用的优化手段不同。
分享文章