品牌在AI搜索中的可见性:LLM监控与内容应对策略
过去几个月,我最大的感受是:即便谷歌排名没掉,订单量却在莫名其妙地减少。后来才发现,大量潜在客户已经转去问ChatGPT、Claude和Perplexity做购买决策,而我的品牌在这些AI模型里要么被错误描述,要么根本没出现。从那时起,我开始用LLM跟踪工具监控品牌在AI搜索中的真实表现,并探索如何把监控到的差距转化为内容行动。
有一组数据让我睡不着觉:AI模型引用的来源轮换率高达52%。也就是说,你今天在ChatGPT回答里看到的内容,隔一个月可能就被替换成竞争对手的信息。品牌在AI搜索中的可见性不是一劳永逸的事,而是一个需要持续监测和干预的动态过程。
为什么你必须监控品牌在AI搜索引擎中的可见性
我先说说自己遇到的状况。去年第四季度,我看到Google Search Console上的点击量没有明显下滑,心里还算踏实。直到有一天我从Perplexity上搜索自己品牌的品类关键词,发现AI给出的购买建议列表里根本没有我。排在前面的两个品牌,其中一个我在上个月还从没听说过。我顺着链接点进去,发现那个品牌的独立站内容质量并不比我好,但它在AI模型中被引用的频率明显更高。
AI搜索正在蚕食传统搜索流量,尤其在购买决策阶段。用户不再输入几个关键词然后翻看搜索结果页,而是直接问ChatGPT或Gemini:“哪个品牌的XX产品性价比最高?”如果品牌在这些回答里缺席,你连被用户评估的资格都没有。更糟糕的是,如果AI模型错误描述了你,比如把产品价格、功能或适用场景说错了,用户对你的信任可能在第一次接触时就受损。
监控不是可选项。它是我理解真实市场位置的必修课。我花了两周时间,逐个测试了多个LLM跟踪工具,试图弄明白一个基本问题:在ChatGPT、Claude、Gemini和Perplexity这些模型眼里,我的品牌到底长什么样。
LLM跟踪工具的核心能力与选择标准
市面上能做LLM跟踪的工具不少,但真正能用的不多。我筛选时主要看五个维度。
多模型覆盖是最基础的底线。如果你的工具只监控ChatGPT,那你看到的只是AI搜索的冰山一角。Gemini和Perplexity的引用逻辑完全不同,Claude对品牌描述的风格偏好也不一样。只监控一个模型,得到的数据是有偏差的。
准确性检测是我最在意的功能。工具不仅要告诉我“品牌被提到了”,还要指出模型提到的信息是否有误。比如有次我发现ChatGPT推荐了我们的产品,但说它只支持Shopify——实际上我们已经接入了WordPress等多个平台。这种错误如果不修正,每被引用一次就损失一次转化。
竞品对比决定了监控数据的意义。单独看自己的可见性分数没有价值,只有放在竞争环境中对比,才能判断你在AI搜索中的真实位置。
情感分析追踪正面、中性和负面提及的比例。我关注的是:当AI回答用户问题时,对品牌的态度是推荐、中立还是质疑?这个比例直接影响用户决策。
最后还要看工具能否给出优化建议。只看仪表盘没有用,我需要知道下一步该做什么。这点我在通过写博客获取搜索流量的经验分享里也提到过——数据和行动之间不能有断层。
当监控到可见性差距——从数据到行动的闭环
监控本身不创造价值,行动才是目的。但在行动之前,得先理解差距到底出在哪里。
我曾经花了两周手工写了一篇深度长文,结果发现ChatGPT引用的是竞争对手的内容。不是因为我的文章写得不好,而是因为我没有考虑AI模型的结构化数据偏好。ChatGPT的引用逻辑不仅看内容质量,更看重内容的可提取性——是否有清晰的问答对、实体标注、结构化数据。我的文章虽好,但在AI模型看来,它不如竞争对手那篇配有FAQ Schema和实体知识库的短文更容易引用。
这让我意识到:内容质量和数量都不够,必须匹配AI的引用逻辑。
修复可见性差距的路径分三步。第一步是修正错误描述。如果AI对你的品牌说了什么不对的内容,你需要针对性地补充结构化内容——比如在产品页面加上FAQ Schema,或者发布专门回答常见误解的博客。第二步是填补空白领域。当你发现竞争对手被引用而你缺席的关键话题时,就要快速生产覆盖这一主题的AI友好型内容。第三步是持续追踪和迭代,这不是一次性项目。
在将监控数据转化为内容行动的过程中,我最终选择了能够将监控洞察直接转化为自动化内容生产的工具——SEONIB。原因很简单:它可以让我配置品牌知识库、设置内链规则和素材库,保证AI生成的内容既符合品牌调性,又能被搜索引擎和AI模型正确理解。对于如何快速验证产品搜索需求的实操,可以参考我整理的如何快速验证产品的搜索需求。
我第一次跑完全流程后的感受是:以前焦虑品牌在AI搜索中为什么不出现,现在至少知道原因和改法。没有监控数据时,优化像是闭着眼打靶;有了数据之后,每步行动都有方向。后来我把这个工作流整合到了一个平台实现三种AI增长模式的框架里——跟踪、优化、自动化发布形成一个闭环。
构建自动化内容工作流以维持AI搜索可见性
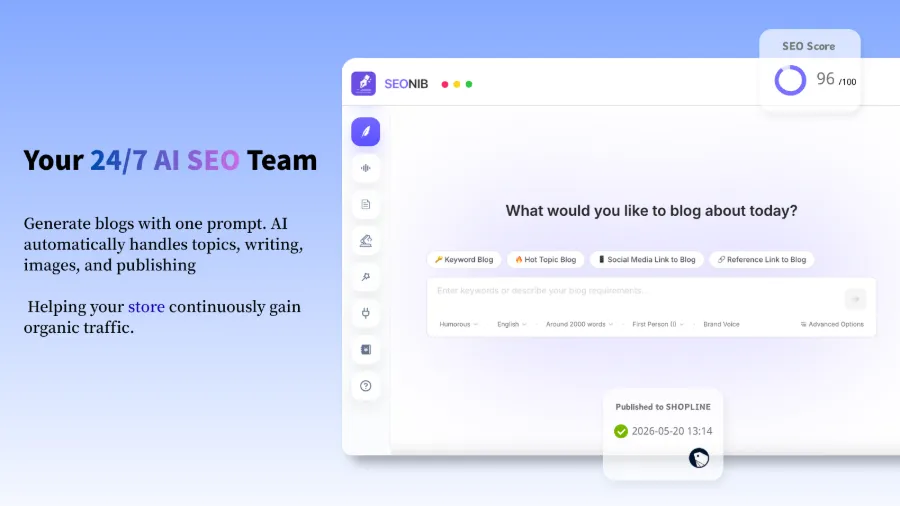
手动逐篇生产内容根本跟不上AI搜索的更新节奏。我试过一个月内每周发两篇高质量文章,但ChatGPT引用模型的更新周期比我快得多——很多时候文章刚发出去,模型已经切换了引用来源。52%的引用轮换率意味着,你必须在持续产出的同时,确保内容结构和格式符合AI模型的解析偏好。
自动化内容流水线解决了两个核心瓶颈:频率和结构。从趋势发现到内容生成到发布同步,每个环节都能用工具自动化。我现在的做法是将商品链接自动转化为博客和问答内容,然后设定定时发布,由系统自动同步到各平台。
YouTube:https://www.youtube.com/watch?v=MiQmHktMVDg
以下表格是我在实际运营中对比两种流程的感受:
| 工作节点 | 传统手动流程 | 自动化工作流 |
|---|---|---|
| 趋势发现 | 每天手动看热搜和竞品 | AI自动监测并推送话题到选题库 |
| 内容生成 | 打开ChatGPT生成后复制粘贴 | 输入来源后直出SEO文章 |
| SEO优化 | 逐篇加图片、元描述、内链 | 内置优化规则自动执行 |
| 发布同步 | 挨个登录各平台上传 | 一次发布同步到所有平台 |
| 持续频率 | 靠毅力和排期表维持 | 系统按计划自动执行 |
表格下方要补充的是:我选择SEONIB而不是其他工具的原因,在于它把这些自动化节点打通了——从商品链接到博客内容再到发布同步,中间没有断层。对比之下,之前用过的一些AI写作工具只能生成文本,后续的SEO优化、多平台发布还得手动处理。对于WordPress场景下的工具选择,可以参考WordPress场景下如何选择SEO工具这篇对比分析。
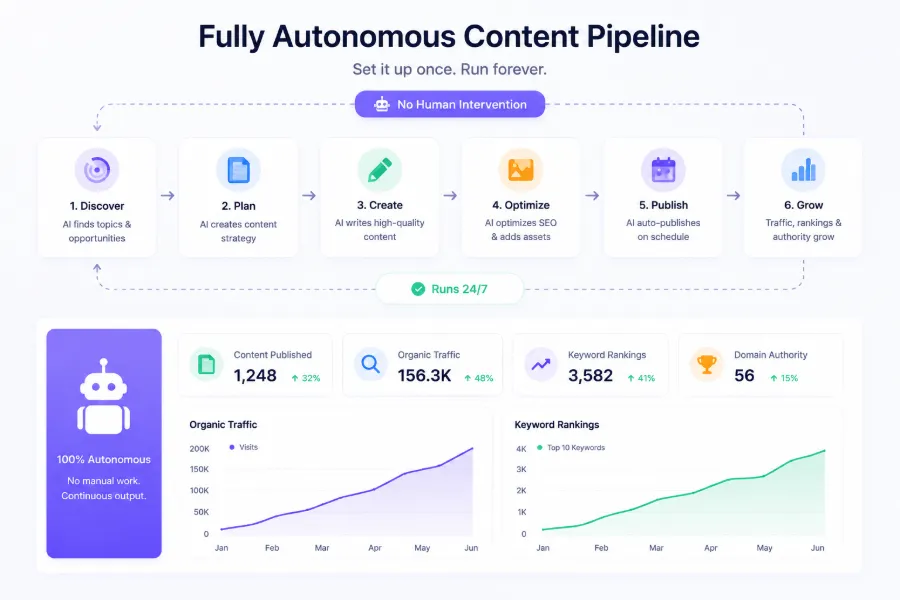
自动化工作流上线后,我的博客更新频率从每周2篇提升到每周10篇以上,而且每篇都包含了SEO优化的基础元素。更重要的是,我发现AI模型引用我品牌的频率也在上升——因为我在每篇文章里都嵌入了问答对和实体知识,符合ChatGPT和Gemini的引用逻辑。这个反馈机制一旦建立,可见性就不再是随机的。
关于具体的发布方案,可以查看seonib收费方案了解不同档位的发布频率和平台支持。如果想进一步了解从商品链接到SEO博客的完整转化流程,推荐阅读将产品链接转化为SEO博客驱动持续自然流量—这套方法经过多个独立站验证,对起步阶段的品牌尤其适用。
FAQ
Q1: LLM跟踪工具和传统SEO工具有什么区别?
传统SEO工具监控的是搜索引擎结果页的排名、点击量和关键词表现。LLM跟踪工具监控的是AI模型在回答问题时如何引用的品牌——是否提到你、怎么描述你、和谁一起被提及。两者数据维度不重叠,但互补。我目前的判断是,传统SEO数据反映历史表现,LLM监控数据反映用户未来决策路径上的概率。
Q2: 品牌在AI搜索中完全没有出现该怎么办?
先做一步验证:用不同AI模型搜索你的品牌名和品类核心关键词,确认是真的“不出现”还是模型版本差异。如果确认缺失,从最快见效的行动开始——创建FAQ页面并加上结构化数据,发布几篇针对常见购买问题的问答对内容,确保网站有清晰的Knowledge Graph实体链接。一般2到4周内,部分模型会开始引用。
Q3: LLM跟踪工具能覆盖所有AI模型吗?
大多数工具覆盖ChatGPT、Gemini、Claude、Perplexity这四个主流模型,部分还支持Google AI Overviews、Grok、DeepSeek和Copilot。但没有任何工具能做到100%覆盖所有AI模型版本。我建议优先覆盖用户群体最集中的2到3个模型,而不是追求全覆盖。
Q4: 我应该多久检查一次品牌在AI搜索中的可见性?
参考引用轮换率52%的数据,建议至少每周检查一次。模型引用的更新周期大约在7到14天之间,尤其注意新版本发布后的前后对比。我养成的习惯是每周一上午跑一次全模型扫描,记录变化点,然后根据变化安排本周的内容生产优先级。
Q5: 监控到的数据如何转化为实际内容优化?
数据和内容之间需要一个翻译环节。监控到错误描述→补充对应的结构化内容和FAQ Schema。监控到竞品被你缺席的话题覆盖→生产这个话题的问答对和深度文章。监控到正面提及率低→检查品牌在AI训练数据中的信息来源是否足够权威。关键在于不要照搬监控建议,而是理解每个数据点背后的引用逻辑差异。
分享文章