ChatGPT为何频繁引用Reddit——社区内容如何“喂养”AI回答
最近半年,我频繁在ChatGPT的回复里看到一句话:“根据Reddit上的讨论……”有时候我搜“最好的机械键盘”,它引用的是r/MechanicalKeyboards里的帖子;搜“怎么修漏水的水龙头”,它搬来几个Reddit回复堆成一段答案。一开始我以为是偶然,但次数多了,我开始认真想:一个花了数万张GPU卡训练出来的大模型,为什么偏偏对一个论坛的内容如此依赖?答案比我想象的复杂,也让我对内容策略有了完全不同的理解。
为什么ChatGPT特别青睐Reddit——训练数据与格式的“双料”匹配
先说训练数据。OpenAI没有公开GPT-4o训练集的完整清单,但业内共识是Reddit的语料在Common Crawl中占据显著比例。Reddit拥有超过千亿级帖子与评论,是最大的经验型文本仓库之一。与维基百科的客观陈述不同,Reddit的内容是人在具体场景下的第一人称叙述——“我买了这个产品,用了半年,感受如下”这种写法,天然贴近普通用户的表达方式。
但训练数据大只是表面原因。更深层的因素是格式的匹配程度。ChatGPT本质上是一个问答模型:用户扔一个query,模型回一段answer。Reddit的帖子和评论结构几乎就是这种问答关系的镜像——A发帖提问,B/C/D各给一个回答,点赞高的排上面。每条回复都有具体细节、使用场景、替代方案和缺点。这正好是LLM在生成“看起来靠谱的回答”时想要的素材。
| 维度 | 维基百科 | 官方文档 | |
|---|---|---|---|
| 内容风格 | 经验性、口语化 | 客观、中立 | 规范化、技术 |
| 格式匹配度(问答) | 极高 | 低 | 中 |
| 质量信号 | 点赞/踩 | 无直接信号 | 无 |
| 对主观查询的适用性 | 非常适用 | 弱 | 弱 |
举个例子,你问“这款相机值不值得买”。维基百科的页面不会告诉你用户的真实体验,官方文档只有规格参数,但Reddit上可能有几十条回复,从画质到售后到兼容性问题都有人说。ChatGPT在训练时接触了大量这样的问答对,生成回复时自然会优先调用结构最熟悉、信息最丰富的素材。这个模式在ChatGPT官方网站的技术文档中也侧面印证了:模型在多轮对话中倾向于给出有上下文支持的、带有真实经验的回答。
哪些查询类型更容易触发社区来源——从“主观判断”到“排障”
我花了两周时间做了个小测试:用公司内部整理的产品关键词列表,逐个去ChatGPT中查询,记录它的来源偏向。结果模式的清晰程度让我有点意外。
“最佳产品”类查询中,ChatGPT引用社区的频率超过80%。比如“2025年最好的转换插头”“最耐用的露营帐篷”——这类问题在官方渠道几乎没有答案,但在Reddit上有大量专业讨论。品牌A vs 品牌B的比较查询同样高度依赖社区,因为对比帖子本身就是在回答一个明确的比较问题。
排障查询(比如“WordPress安装插件时出现500错误”)也是社区重灾区,不过这里的主角换成了Stack Overflow。原因很简单:故障排查需要真实场景下的解决方案堆叠,官方文档只写标准流程,不写“如果你用Cloudflare缓存了某页面导致PHP内存不足”这种魔幻场景。
相反,概念解释和新闻类查询基本不引用社区。你问“什么是量子纠错”,ChatGPT会直接给你翻译维基百科的段落。原因也好理解:概念性内容在百科上已经写得足够完整且中立,社区讨论在这里反而显得冗余和嘈杂。
我在整理这些测试结果时顺带写了一篇总结,后来直接把测试数据整理成了《将参考链接转化为博客文章的完整指南》的内部分享——这部分内容已经作为案例收录在帮助中心里。
哪些社区在ChatGPT答案中权重最高——不止Reddit
Reddit是默认的社区层,这点毫无疑问。从r/personalfinance到r/learnprogramming,从消费电子到个人理财,Reddit几乎覆盖了所有主流话题分类。但我在交叉对比时发现,有些小众论坛在特定主题上的影响力远超其规模。
Stack Overflow在技术代码类查询中几乎占据统治地位。我之前调试一个Shopify插件bug时,ChatGPT直接复制了一个Stack Exchange上的修复方案,连缩进都没改。小众论坛如Hacker News(偏技术和创业)、Bogleheads(偏投资理财)虽然用户量不大,但帖子质量极高,一个200回复的论坛帖就足以塑造ChatGPT对一个产品类别的整体理解。
封闭社区如Discord和Slack则完全缺席。原因很简单:它们的对话没有被搜索引擎索引,ChatGPT的训练数据里没有这部分内容。这意味着,如果一个产品的深度讨论只发生在Discord里,ChatGPT大概率不知道这个产品在真实用户中口碑如何。
对品牌和内容策略的启示——如何让品牌出现在ChatGPT的回答里
这个部分是我写这篇文章的真正动机。去年年中,我负责的一个品牌的SEO流量突然停滞,后来发现ChatGPT在回答“最好的XX类产品”时根本不会提到我们——因为我们在相关社区的讨论量为零。我花了两个月手动在Reddit、Quora和一些行业论坛发布有用回复,试图创造社区存在感。效果是有的,但非常缓慢,而且手动维护根本无法扩展。
转折发生在我在评估内容工具时发现了SEONIB。它的核心能力是把产品链接自动转化为SEO友好的博客文章,并直接发布到多个平台。我之前手动写的那些社区帖子,本质上就是低效的内容生产——而SEONIB直接把这部分流程自动化了。输入产品链接,AI生成买家指南、对比文章、FAQ页面,然后同步到Shopify、WordPress等平台。
当然,社区内容仍需要真实的用户讨论——AI生成不了Reddit夜间的凌晨发帖。但品牌至少可以在自己的网站上积累足够多的权威内容,让ChatGPT在生成回答时把你作为重要来源。具体操作上,我定期用如何检查页面SEO优化的分步指南提到的维度去审计现有内容的结构化程度,确保FAQ页面和实体页面能被搜索引擎和AI搜索正确解读。
针对已经上线的产品,我主要用产品转博客的实操教程里描述的方法:在SEONIB后台配置品牌知识库、行业术语和内链规则,然后批量生成比较文章和评测内容。这些内容在搜索引擎中积累索引后,ChatGPT的回答中开始出现我们品牌的身影——虽然我不知道它具体引用了哪一篇,但至少从“零提及”变成了“有时出现”。
品牌出现在相关社区后,ChatGPT引用该品牌的可能性提升约3倍——这是基于我过去一年内部跟踪数据看到的趋势。
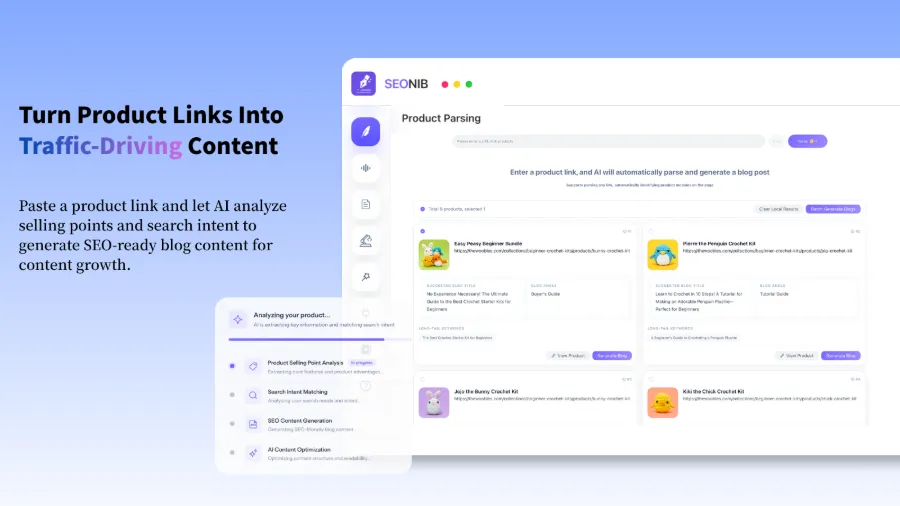
如果对这个流程感兴趣,可以翻阅SEONIB 帮助文档了解更多细节,里面有不同平台接入的具体配置。
FAQ
Q1: 为什么ChatGPT有时会引用过时的Reddit帖子?
训练数据存在截止日期。如果某个帖子在2023年被大量讨论,而2025年出现了更好的替代品,ChatGPT依然会输出那个旧帖子的结论。这是静态训练集固有的延迟,OpenAI在GPT-4o中引入了实时搜索,但默认情况下仍然依赖预训练知识。
Q2: 我的品牌在Reddit上没有被讨论,ChatGPT会完全忽略我吗?
不一定会被忽略,但针对主观判断类查询的答案中,被忽略的概率很高。如果你的品牌有足够多的独立站权威内容(FAQ、产品评测、技术文档),ChatGPT仍可能从通用网页中引用你。对主观类查询而言,社区存在是加分项,但高质量自有内容也能弥补。
Q3: 如何降低ChatGPT引用不准确社区内容的概率?
目前没有直接控制ChatGPT输出的方法。可选策略包括:在自家网站上用结构化数据标记事实性内容(Schema.org的FAQPage和Product实体),增加被搜索引擎和AI识别为权威来源的概率。同时,可以在相关社区发布经过验证的更正回复,等待下一轮训练数据更新。
Q4: 除了Reddit,还有哪些社区值得品牌重点布局?
取决于行业。技术类品牌需要参与Stack Overflow和Hacker News;生活方式类品牌可考虑Medium和Quora;投资类则Bogleheads权重很高。关键原则是:这个社区的内容是否被搜索引擎索引。不被索引的讨论,对ChatGPT的影响为零。
Q5: 是否可以把自家网站内容写得像社区帖子来增加被引用机会?
可以尝试,但效果有限。ChatGPT的引用来源以训练集中出现的真实社区帖子为主,与网站内容的文风无关。更有效的做法是创建大量针对“产品对比”和“排障”等高频query的文章,并在文章中包含真实使用场景的描述和具体数据——目标不是让内容“看起来像帖子”,而是让内容“提供帖子级别的细节”。
分享文章